

Em agosto deste ano, publicamos aqui no Encontrabilidade dois posts sobre a marca d’água da Anthropic no Claude. Primeiro, “Anthropic passa a marcar todo o texto gerado pelo Claude, e isso afeta todo mundo que usa IA”, e depois, com ângulo editorial próprio, “A marca d’água do Claude não é o problema. É o espelho.” Nos dois textos, apontamos que a decisão da Anthropic de aplicar a marca d’água globalmente, e não apenas na União Europeia, sinalizava algo além de uma obrigação regulatória. Era uma aposta de posicionamento.
Agora em outubro, a OpenAI anunciou o textGrain. E o movimento, que parecia isolado, ganhou um segundo nome.
O que é o textGrain e como funciona
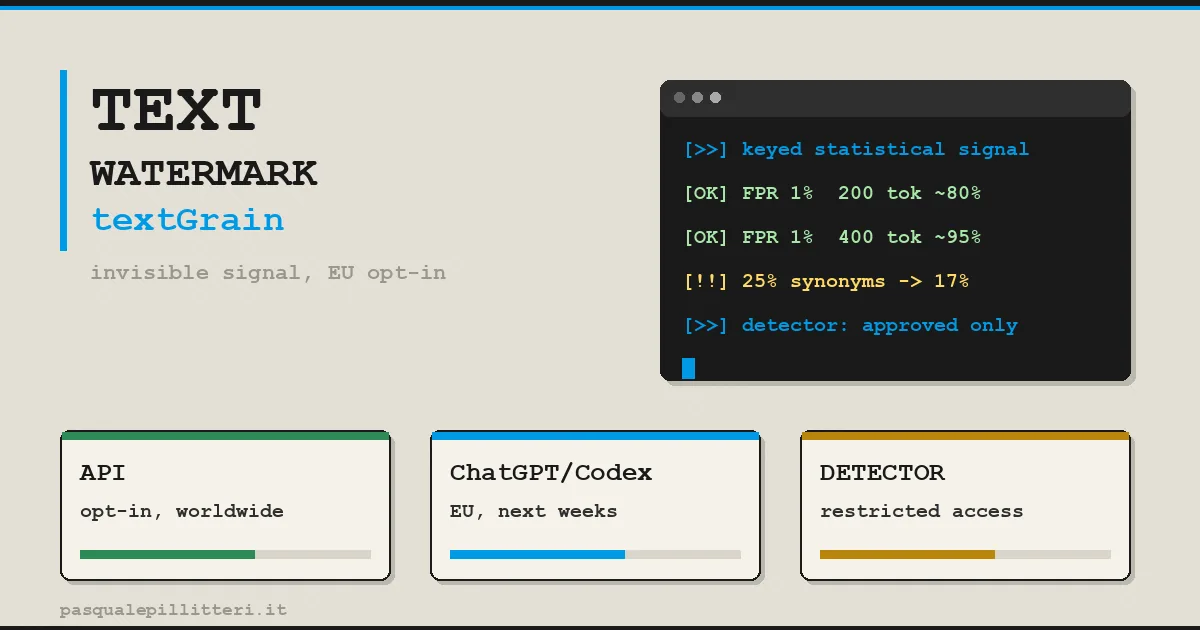
O textGrain é o sistema de marca d’água invisível desenvolvido pela OpenAI para o ChatGPT e para o Codex, sua plataforma de geração de código. O anúncio foi feito no último dia 5 e a implementação começou a ser liberada nas semanas seguintes de forma gradativa para usuários da União Europeia .
O mecanismo funciona de forma diferente do que a maioria das pessoas imagina quando ouve a expressão “marca d’água”. Não se trata de um caractere invisível inserido no texto, nem de espaços adicionais ou qualquer elemento gráfico oculto. O textGrain é um sinal estatístico, construído durante o próprio processo de geração do texto.
Funciona assim: ao escolher cada palavra da resposta, o modelo realiza um processo de seleção entre várias opções linguisticamente equivalentes. O textGrain interfere sutilmente nessa seleção, criando um padrão nas escolhas que é invisível para o leitor humano, mas detectável por quem tem acesso à chave de verificação da OpenAI. O resultado final, em termos de significado e qualidade do texto, é idêntico ao que seria gerado sem a marca. A diferença está na distribuição estatística das palavras escolhidas.
O contexto regulatório que explica o timing
O textGrain não surgiu do nada. Ele responde diretamente a uma exigência legal específica.
Em 2 de agosto de 2026, entrou em vigor o Artigo 50 do AI Act, a Lei de Inteligência Artificial da União Europeia, que estabelece diretrizes obrigatórias de transparência para sistemas de IA. Uma das obrigações é que conteúdo gerado por IA seja identificável como tal.
A OpenAI escolheu a marca d’água estatística como sua forma de cumprir essa exigência para texto e código. O AI Act não obriga especificamente o uso de marca d’água, mas a Empresa optou por essa abordagem como solução técnica para o requisito de identificabilidade.
É o mesmo cenário regulatório que levou a Anthropic a implementar a marca d’água no Claude dois meses antes. A diferença é que a Anthropic aplicou a mudança globalmente desde o início, enquanto a OpenAI está começando pelos usuários da União Europeia.
O que o textGrain não faz
Parte da reação pública ao anúncio veio de interpretações equivocadas sobre o alcance do sistema. Vale desfazer os principais equívocos.
O textGrain não identifica quem escreveu o prompt. A marca d’água indica que o texto foi gerado pelo ChatGPT, não quem fez o pedido. Conversas, prompts e identidades dos usuários não estão acessíveis pelo detector.
O textGrain não é infalível. A própria OpenAI admite dois tipos de erro no sistema: falsos positivos, quando o detector indica marca d’água num texto que não tem, e falsos negativos, quando a marca está presente mas não é detectada. Em ensaios controlados, o sistema detectou a marca em 80% dos textos curtos com 200 tokens. Em condições reais de uso, o desempenho pode ser menor.
O textGrain pode ser enfraquecido. A substituição de sinônimos, a paráfrase humana e a edição intensiva do texto gerado podem degradar o sinal estatístico a ponto de torná-lo indetectável. A marca d’água sobrevive a copiar e colar, mas não necessariamente a uma revisão editorial completa.
O detector não está disponível ao público geral. No lançamento, o acesso ao sistema de verificação foi restrito a pesquisadores e organizações especializadas aprovadas pela OpenAI. Os resultados indicam apenas se há ou não marca d’água da OpenAI no texto, sem revelar mais nada.
A comparação com o SynthID e o que ela revela
A OpenAI afirmou que o textGrain igualou ou superou outras soluções testadas internamente, incluindo o SynthID para texto, desenvolvido pelo Google DeepMind.
O SynthID, para quem não conhece, é o sistema de marca d’água do Google para conteúdo gerado pelo Gemini. Ele foi lançado antes e funcionava inicialmente apenas para imagens, com versão para texto adicionada posteriormente.
A comparação feita pela OpenAI com o sistema do Google tem um duplo significado. Primeiro, é um argumento técnico legítimo: o textGrain foi desenvolvido e avaliado em comparação com soluções já existentes no mercado. Segundo, é uma declaração de posicionamento competitivo: a OpenAI não quer ser vista como atrasada num campo em que o Google já atua.
O padrão que emerge é o de uma corrida discreta entre os principais laboratórios de IA para estabelecer padrões de identificabilidade antes que reguladores ao redor do mundo imponham soluções próprias.
O que mudou entre agosto e outubro
Quando a Anthropic implementou a marca d’água no Claude, em agosto, a reação do mercado foi amplamente negativa. O debate que se seguiu, que cobrimos aqui em detalhes no post “A marca d’água do Claude não é o problema. É o espelho”, revelou mais sobre a tensão entre conveniência e transparência do que sobre os detalhes técnicos do sistema propriamente dito.
Dois meses depois, com a OpenAI seguindo o mesmo caminho, o debate mudou de tom. A pergunta deixou de ser “por que a Anthropic está fazendo isso?” e passou a ser “para onde isso está indo?”.
A resposta mais provável é: para todos os lugares. O AI Act europeu está criando um precedente regulatório que tende a se expandir. Outros mercados, incluindo o Brasil, observam as iniciativas europeias como referência para suas próprias regulações de IA. A Estratégia Brasileira de Inteligência Artificial, publicada em 2021 com processo de revisão iniciado em dezembro de 2023, já mencionava transparência e identificabilidade como princípios orientadores, sem ainda detalhar mecanismos técnicos específicos.
O que a convergência entre Anthropic e OpenAI sinaliza é que a marca d’água estatística em texto está deixando de ser uma opção regulatória específica para se tornar uma infraestrutura padrão do ecossistema de IA generativa.
O que isso muda para quem usa IA para produzir conteúdo
Na prática, para quem usa o ChatGPT como ferramenta de trabalho, o textGrain não muda nada visível no dia a dia. O texto gerado parece e funciona exatamente igual. A diferença está numa camada estatística que o usuário não vê e que, na maior parte dos casos, não vai afetar o uso do conteúdo.
As implicações mais concretas ficam nos casos de uso onde a identificabilidade importa:
- Em contextos educacionais, o textGrain pode ser usado para verificar se um trabalho foi gerado pelo ChatGPT, embora com as limitações de falsos negativos e da vulnerabilidade à edição humana.
- Em publicações jornalísticas e de conteúdo editorial, a presença da marca pode ser relevante para verificação de origem, especialmente em investigações sobre desinformação.
- Para marcas e empresas que usam o ChatGPT para gerar conteúdo em larga escala e publicam sem revisão editorial, a existência do detector, mesmo que restrito, adiciona uma camada de rastreabilidade que antes não existia.
A posição da OpenAI é explícita sobre as limitações do sistema: “A marca d’água de texto e sua detecção continuam sendo tecnologias iniciais com limitações significativas, e as visões sobre seus benefícios e usos responsáveis ainda estão em desenvolvimento.”
Essa transparência sobre as próprias limitações é, ela mesma, um dado relevante. Num mercado que tende a exagerar as capacidades dos sistemas de detecção de IA, a honestidade técnica da OpenAI sobre o que o textGrain não consegue fazer merece mais atenção do que o anúncio em si.
Perguntas frequentes sobre o textGrain da OpenAI
1. O que é o textGrain e como ele funciona tecnicamente?
O textGrain é o sistema de marca d’água invisível desenvolvido pela OpenAI para o ChatGPT e para o Codex. Em vez de inserir caracteres ocultos ou espaços adicionais, o sistema atua durante o próprio processo de geração do texto, modificando sutilmente a seleção estatística de palavras do modelo. Esse padrão de escolhas é invisível para o leitor humano, mas detectável por quem tem acesso à chave de verificação da OpenAI. A OpenAI afirma que o textGrain igualou ou superou outras soluções testadas internamente, incluindo o SynthID para texto, desenvolvido pelo Google DeepMind.
2. Por que a OpenAI implementou o textGrain agora, em outubro de 2026?
O anúncio do textGrain responde diretamente à entrada em vigor do Artigo 50 do AI Act, a Lei de Inteligência Artificial da União Europeia, em 2 de agosto de 2026. O texto da lei estabelece diretrizes obrigatórias de transparência para sistemas de IA, incluindo a exigência de que conteúdo gerado por IA seja identificável como tal. A OpenAI escolheu a marca d’água estatística como sua solução técnica para cumprir essa obrigação para usuários do ChatGPT e do Codex na União Europeia.
3. O textGrain pode identificar quem pediu o texto ao ChatGPT?
Não. A marca d’água indica apenas que o texto foi gerado pelo ChatGPT ou pelo Codex, sem revelar quem fez o pedido. A OpenAI foi explícita sobre isso: conversas, prompts e identidades dos usuários não são acessíveis pelo detector. Os resultados da verificação indicam somente se há ou não marca d’água da OpenAI no texto analisado.
4. É possível remover a marca d’água do textGrain?
Sim, em parte. O sinal estatístico do textGrain pode ser enfraquecido por substituição de sinônimos, paráfrase humana intensa ou edição editorial completa do texto gerado. A marca sobrevive a simples operações de copiar e colar, mas não necessariamente a uma revisão editorial profunda. A própria OpenAI reconhece duas limitações técnicas do sistema: falsos positivos, quando o detector indica marca d’água onde não há, e falsos negativos, quando a marca está presente mas não é detectada.
5. Qual é a diferença entre o textGrain da OpenAI e a marca d’água do Claude, da Anthropic?
Ambos são sistemas de marca d’água estatística em texto, com funcionamento técnico semelhante: modificam sutilmente a seleção de palavras durante a geração sem alterar o significado do conteúdo. A principal diferença está no escopo de implementação inicial: a Anthropic aplicou a mudança globalmente desde o lançamento, em agosto de 2026, enquanto a OpenAI começou pelos usuários da União Europeia, em outubro do mesmo ano. Ambas as decisões respondem ao mesmo contexto regulatório do AI Act europeu, mas refletem estratégias diferentes sobre como e para quem implementar a mudança primeiro.


